Cet article explore les enjeux de contrôle des accès dans les environnements data modernes, caractérisés par une multiplication des usages, des volumes et des points d’exposition. Il revient d’abord sur les principaux modèles de gestions des accès ainsi que sur les mécanismes appliqués directement à la donnée afin d’en rappeler les promesses et les limites. Il analyse ensuite les capacités offertes par les plateformes du marché et met en évidence à travers des retours terrain et un Proof of Concept, les écarts entre ces approches théoriques et leur mise en œuvre réelle. Enfin, il identifie les causes structurelles de ces fragilités, notamment l’absence de fondations de gouvernance et propose une lecture par niveaux de maturité pour aider les organisations à progresser vers une sécurisation plus cohérente, durable et adaptée aux nouveaux usages, en particulier ceux liés à l’intelligence artificielle.
Une surface d’attaque qui explose côté data
Les organisations n’ont jamais manipulé autant de données. Data lakes, data warehouses, plateformes de BI, pipelines alimentant des modèles d’IA : l’écosystème analytique s’est considérablement élargi, et avec lui, le nombres d’utilisateurs, de systèmes et de points d’accès à sécuriser. Là où l’accès aux données était autrefois structuré, encadré et prévisible, il est aujourd’hui distribué, ouvert et souvent mal maîtrisé.
Le chiffre est parlant : selon IBM, le coût moyen d’une fuite de données dépasse désormais 4 millions de dollars1. Les environnements data modernes, par la richesse et la sensibilité des informations qu’ils concentrent, sont en première ligne.
Pourtant, la question n’est pas de savoir si les modèles de contrôle d’accès adaptés existent (c’est le cas et depuis un certain temps). La vraie question est : les environnements data appliquent-ils réellement les principes IAM, du moindre privilège et du Zero Trust ? L’honnêteté oblige à répondre : rarement, et rarement bien.
Des modèles de contrôle d’accès matures… sur le papier
Les référentiels ne manquent pas. Du plus élémentaire au plus sophistiqué, les mécanismes de contrôle d’accès couvrent un spectre large :
ACL (Access Control List) et RBAC (Role Based Access Control) constituent le socle historique. Simple à déployer et bien supportés nativement, ils restent le point de départ de la très grande majorité des environnements. Leur limite est connue : à grande échelle, les ACL deviennent ingérables objet par objet, et le RBAC génère une prolifération de rôles qui reproduit la complexité qu’il était censé résoudre.
L’ABAC (Attribute Based Access Control) représente la réponse théorique la plus aboutie. En conditionnant les décisions d’accès à des attributs dynamiques portés par l’utilisateur, la ressource et le contexte, il offre une granularité et une flexibilité bien supérieures. Mais son déploiement reste conditionné à un prérequis exigeant : disposer d’un référentiel d’attributs standardisé, maintenu et gouverné à l’échelle de l’organisation.
L’ABE (Attribute Based Encryption) pousse ce principe jusqu’à la couche cryptographique : les données sont chiffrées selon des politiques d’attributs, rendant toute lecture impossible sans les attributs requis, indépendamment des contrôles applicatifs. Pertinent pour les données les plus sensibles, nous n’avons à ce jour observé ce mécanisme que dans une version allégée dans un domaine militaire spécifique (Data Centric Security) dû à la complexité de gestion des clés et l’absence de support natif dans les plateformes du marché.
RLS/CLS (Row/Column Level Security) et DDM (Dynamic Data Masking) opèrent directement au niveau de la donnée.
- Le RLS filtre les lignes restituées par une requête en fonction du profil ou des attributs de l’utilisateur ;
- Le CLS restreint l’accès à certaines colonnes en fonction des droits de l’utilisateur, en masquant ou excluant les champs sensibles du résultat ;
- Le DDM remplace à la volée les valeurs sensibles par des données masquées selon le profil de l’utilisateur, sans altérer les données stockées.
Ces mécanismes présentent l’avantage d’être proches de la donnée, ce qui garantit une application cohérente quel que soit l’outil consommateur. Ce sont aujourd’hui les mécanismes les plus opérationnels et les plus directement actionnables dans les environnements de production.
Le QBAC (Query Based Access Control) pousse la logique encore plus loin : plutôt que de filtrer des lignes ou des colonnes, il réévalue et réécrit la requête elle-même au moment de son exécution selon des règles contextuelles. Cette approche, très similaire aux techniques de query rewriting étudiées en recherche pour le contrôle d’accès fin, offre une grande flexibilité et un fort potentiel d’adaptation mais reste aujourd’hui peu standardisée et rarement industrialisée (dans les déploiements observés, QBAC est souvent combiné directement avec du DDM).
Enfin, le JIT (Just-In-Time Access) n’agit pas sur la donnée mais sur la durée des privilèges : les droits élevés ne sont accordés que le temps strictement nécessaire sur justification, puis révoqués automatiquement, réduisant ainsi l’exposition permanente aux comptes à hauts droits dans une logique Zero Trust. On retrouve ce mécanisme nativement chez les providers cloud mais il est également possible de créer au préalable des rôles/droits pour chaque cas d’usage, puis de les accorder aux utilisateurs en fonction des besoins à travers une plateforme IAM. Une limite non négligeable de ce mécanisme consiste en la validation des droits : Qui doit les valider ? Est-ce suffisamment rapide ? Quel équilibre pour éviter de surcharger les valideurs ?
Plateformes data : des capacités fragmentées
L’analyse des principales plateformes du marché révèle un constat nuancé.
Databricks et Snowflake proposent des capacités de gouvernance natives relativement complètes. Unity Catalog chez Databricks centralise la gestion des droits sur l’ensemble des objets de données, supporte nativement RBAC, ABAC, RLS, CLS et DDM et dispose d’un système d’audit intégré interrogeable directement en SQL. Snowflake offre un modèle similaire avec des Row Access Policies et des Masking Policies gouvernables via des tags. Ces plateformes constituent aujourd’hui les environnements les mieux outillés pour une gouvernance des accès sérieuse.
Power BI et Tableau sont positionnés comme des couches de restitution dont la sécurité est conçue pour s’appuyer sur celle des sources sous-jacentes. Power BI propose du RLS et de l’Object Level Security, mais ces mécanismes ne s’appliquent pas aux utilisateurs possédant les rôles Admin, Member, ou Contributor du workspace dans Power BI Service, qui ont par conséquent accès à l’intégralité du dataset en cas d’absence de mécanisme du côté des plateformes data. Tableau offre des Virtual Connections permettant de centraliser les règles de sécurité mais reste là encore moins développé que les plateformes data spécialisées.
La question qui en découle est fondamentale : où sont réellement définies les règles d’accès ? Dans l’IAM ? Dans la data platform ? Dans l’outil de BI ?
Dans la plupart des environnements observés, la réponse est : un peu partout, sans forcément de cohérence et sans gouvernance ni visibilité centralisée.
Ce que révèle le terrain : sécurité fragile par conception
L’analyse des pratiques observées chez nos clients confirme un écart structurel entre les recommandations théoriques et les déploiements réels. Plusieurs patterns reviennent de manière récurrente.
Le premier : le data lake ouvert, dont les accès sont contrôlés non pas au niveau de la donnée elle-même mais par les applications consommatrices. Chaque application gère ses propres règles de restriction selon l’utilisateur connecté. Ce modèle fonctionne… jusqu’à ce qu’une application soit compromise, mal configurée ou contournée. À ce moment, l’intégralité du lac est potentiellement exposée.
Un deuxième pattern : Les contrôles d’accès existent, mais ils sont remplacés en pratique par les privilèges des applications et des services intermédiaires. Lorsqu’une requête atteint la plateforme de données, celle-ci ne voit plus l’utilisateur d’origine mais uniquement le compte technique utilisé par l’application. Les règles d’accès deviennent alors génériques et souvent plus permissives que nécessaire.
Les mécanismes avancés (dont ABAC fait partie) restent l’exception. D’autres mécanismes plus complexes n’ont à ce jour, pas vraiment été observés en déploiement réel dans un environnement data de production non plus.
Réalisation d’un PoC : nos observations confirmées
Pour valider ces observations, un Proof of Concept a été conduit sur une architecture combinant Power BI Desktop et Databricks avec un jeu de données transactionnel fictif de cinq millions de lignes et six profils utilisateurs couvrant des cas d’usage représentatifs.
L’architecture testée s’articule autour d’Unity Catalog côté Databricks (gouvernance centralisée, SQL Warehouse, tables Delta) et de Power BI Desktop côté restitution, avec deux modes de connexion étudiés en parallèle.
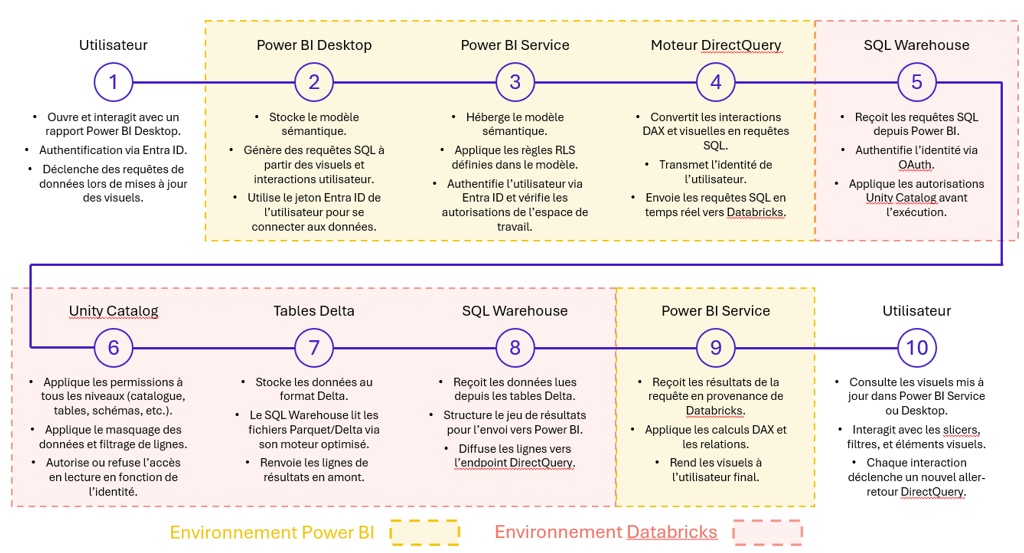
Le constat le plus net concerne la comparaison DirectQuery / Import. En mode DirectQuery, chaque requête est transmise en temps réel à Databricks, l’identité de l’utilisateur est propagée et les politiques Unity Catalog s’appliquent à chaque interaction. En mode Import, les données sont mises en cache dans le moteur VertiPaq de Power BI : les politiques de sécurité Databricks ne s’appliquent qu’au moment du chargement initial et toute modification ultérieure des droits dans Unity Catalog reste sans effet jusqu’au prochain rafraîchissement du dataset. Ce comportement se vérifie expérimentalement : une politique de masquage activée après importation n’a eu aucun effet sur les données déjà en cache.
Le mode Import, plus répandu en entreprise pour ses performances et sa simplicité, constitue donc une vulnérabilité structurelle dans tout environnement manipulant des données à accès différenciés. Il s’agit d’une conséquence directe de l’architecture, qui est souvent ignorée au moment des choix de déploiement. Pour pallier ce problème, l’utilisation du RLS natif de Power BI (à l’aide de DAX dynamique) est possible, bien que moins développé que les contrôles d’accès intégrés aux plateformes data.
Les mécanismes RLS et DDM de Databricks se sont pour leur part révélés fonctionnels et relativement accessibles à l’implémentation, avec une propagation correcte des politiques du schéma vers les tables enfants. Cependant, l’ABAC qu’implémente Databricks reste limité par rapport aux capacités attendues : impossible de prendre en compte les éléments contextuels d’une requête, comme l’heure, l’adresse IP, la localisation et autres (uniquement des tags sur l’utilisateur/groupe et sur les ressources). Une richesse supplémentaire est disponible avec la fédération dans Databricks des groupes définis dans les outils IAM.
Le problème : absence de fondations de gouvernance
Les organisations qui peinent à déployer des mécanismes avancés ne le font pas par ignorance des enjeux. Elles en ont conscience. Ce qui leur manque, ce sont les fondations sur lesquelles ces mécanismes doivent s’appuyer.
Dans la majorité des environnements observés, les lacunes portent sur l’absence de plusieurs briques essentielles, décrites ci-après :
- Une classification des données structurée et maintenue dans le temps, indispensable pour définir des politiques cohérentes de filtrage, de masquage ou de restriction ;
- Un référentiel d’attributs fiable et gouverné, permettant de supporter des approches dynamiques comme l’ABAC ;
- Un catalogue de données centralisé, offrant visibilité, traçabilité, et cohérence dans l’application des règles d’accès ;
- Une gouvernance transverse des accès, alignant les pratiques entre IAM, plateformes data, et outils de restitution ;
- Une implication effective des équipes IAM sur le périmètre data, afin d’éviter une gestion des accès fragmentée.
C’est précisément dans cet espace de gouvernance morcelée que se concentrent les risques les plus significatifs.
Les organisations peuvent résoudre l’équation grâce à une montée en maturité progressive
Face à ce constat, la tentation est de définir un état idéal et de mesurer l’écart. C’est une erreur de positionnement. Toutes les organisations n’ont pas le même niveau de maturité, les mêmes contraintes techniques, ni les mêmes besoins de granularité.
Une approche plus utile consiste à raisonner par paliers progressifs :
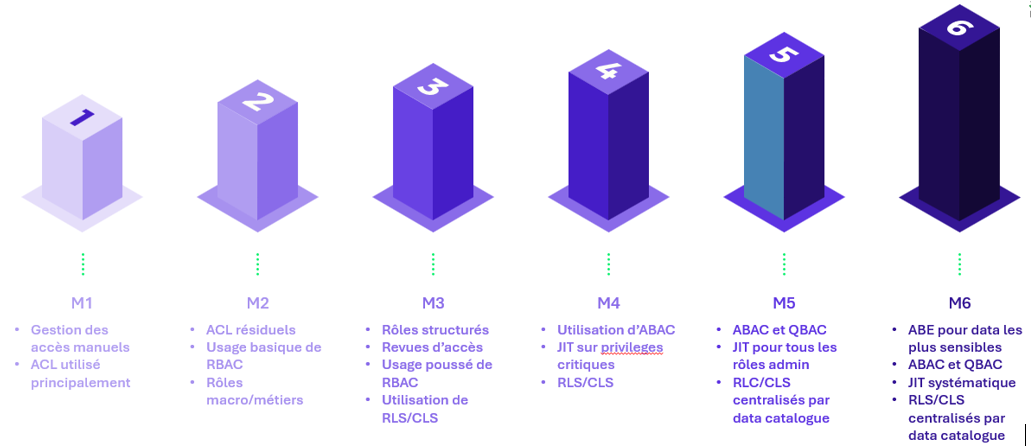
L’objectif n’est pas d’atteindre M6. C’est d’identifier où l’on est, de comprendre ce qui bloque le passage au niveau suivant, et d’investir en priorité sur les fondations manquantes (que ce soit en termes techniques, de gouvernance, ou autres) sans lesquelles aucune progression n’est possible.
Ce qu’il faut retenir
Dans les environnements data modernes, l’enjeu n’est plus seulement de disposer de mécanismes de contrôles d’accès matures (ils existent déjà), mais de les appliquer de manière cohérente, centralisée et réellement opérationnelle.
L’explosion des surfaces d’exposition, la fragmentation des règles entre IAM, plateformes data et outils de BI, ainsi que les écarts observés entre modèles théoriques et implémentations réelles créent une sécurité fragile par conception.
Les retours terrain et le PoC démontrent que des choix architecturaux courants comme le mode Import dans Power BI ou des contrôles applicatifs déportés peuvent introduire des vulnérabilités structurelles, malgré l’existence de capacités théoriquement avancées (RLS, DDM, ABAC).
En réalité la principale limite n’est pas technologique mais liée à l’absence de fondations de gouvernance : classification des données, référentiels d’attributs, catalogue centralisé et intégration des équipes IAM dans les problématiques data.
Dans ce contexte, la sécurisation doit se rapprocher de la donnée et s’inscrire dans une approche progressive adaptée au niveau de maturité (aussi bien organisationnelle que technologique) des organisations. L’essor des usages IA ne fait qu’amplifier cette nécessité en imposant une propagation fiable et dynamique des droits d’accès dans des architectures de plus en plus ouvertes et imprévisibles.
La réponse passe donc par une convergence structurée entre IAM et gouvernance des données, qui devra être à même de garantir un contrôle des accès robuste, scalable et durable à l’échelle des écosystèmes data actuels.