Un musée, un restaurant, un hôtel, une université, un site gouvernemental. Rien ne les rapproche si ce n’est une anomalie : tous remontent dans les résultats de recherche liés à des jeux d’argent en ligne, alors que leur activité n’a pas le moindre rapport avec ce domaine.
Leurs propriétaires l’ignorent encore mais c’est le signe que leur plateforme web a été compromise et que des attaquants en détournent la réputation pour promouvoir des plateformes de jeux d’argent assez douteux.
Le CERT-Wavestone a récemment observé plusieurs cas de ce type. Rien, au premier abord, ne laisse présager une compromission. Pas de défacement, pas de page blanche un lundi matin, pas de client furieux au téléphone. Ces sites tournent. Ils tournent même très bien. Sauf qu’en regardant d’un peu plus près, on découvre que les attaquants ont apporté quelques modifications particulières au code source. Des modifications invisibles pour les visiteurs, mais pas pour les robots et les assistants IA qui parcourent le web.
Dis-moi qui tu es et je te dirai qui je suis
Prenons l’un des cas que nous avons observé récemment. En regardant le code source de la plateforme compromise, l’explication est apparue assez vite. Dans le fichier PHP de la page d’accueil, l’attaquant avait glissé quelques lignes de code, presque anecdotiques au milieu du reste dont voici un pseudo-code :
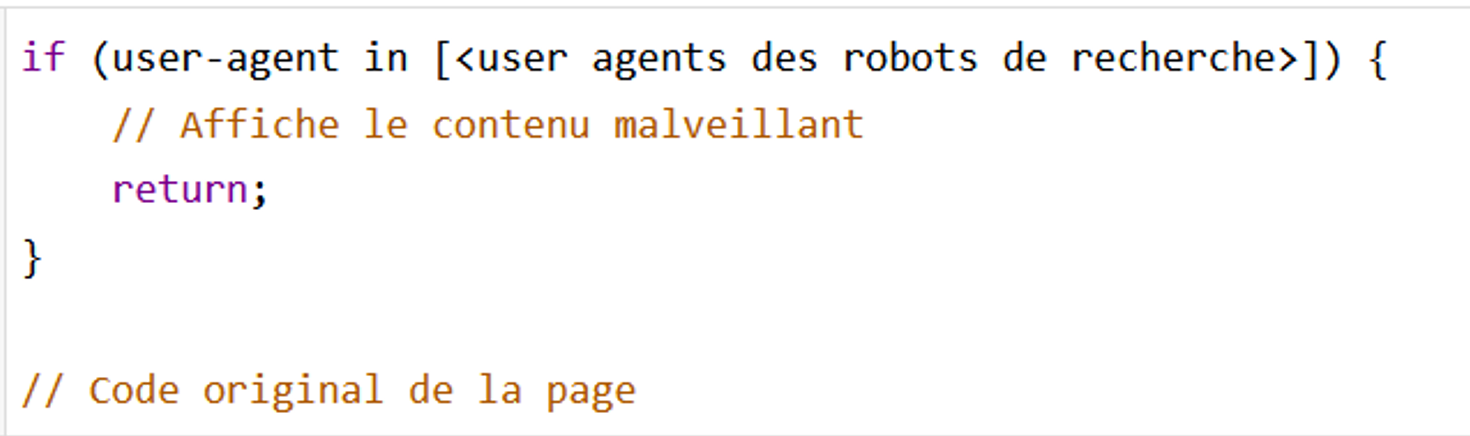
L’idée est aussi simple qu’efficace. À chaque requête, ce petit bout de code regarde l’en-tête User-Agent de celui qui demande la ressource. Si c’est un robot d’indexation (Googlebot, Bingbot et consorts), le serveur lui sert une page entièrement différente, taillée sur mesure, puis coupe immédiatement l’exécution. Si c’est un visiteur humain, (avec un User-Agent d’un navigateur classique) le contenu original du vrai site est affiché. Et comme les humains ne voient jamais la version malveillante, personne ne se doute de rien.
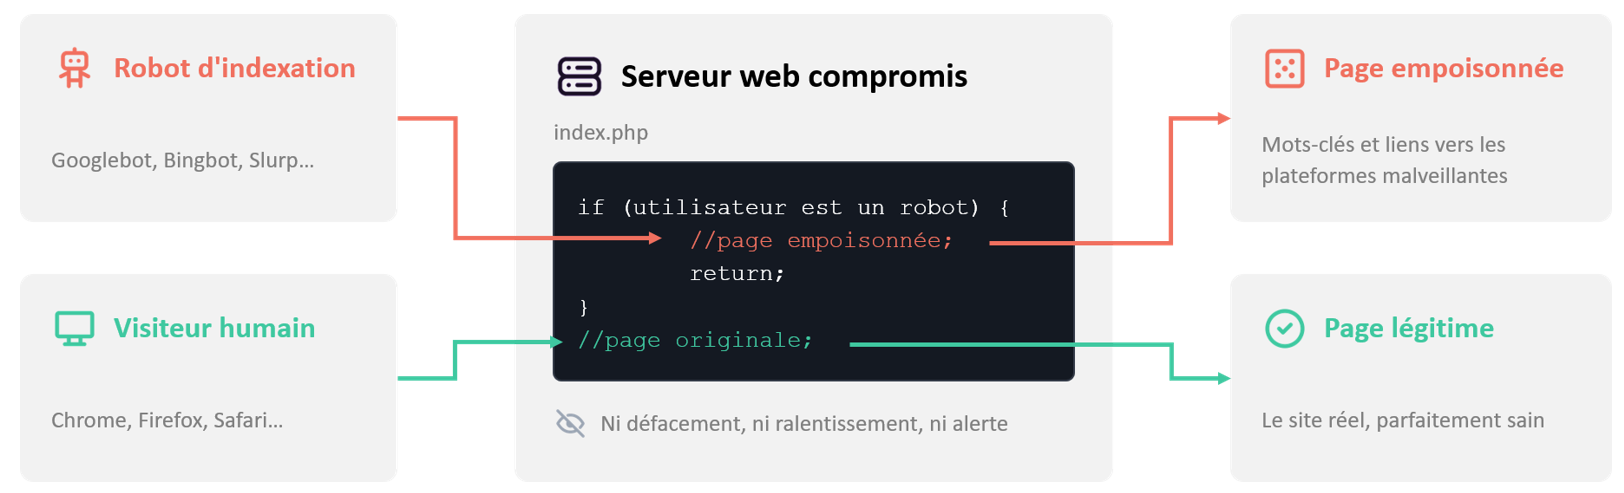
Cette technique porte un nom : le cloaking, ou masquage. Elle consiste à servir un contenu différent selon que la requête provient d’un utilisateur humain ou d’un robot d’indexation. C’est une pratique bien connue du référencement abusif, utilisée de longue date pour contourner les règles des moteurs de recherche et manipuler les classements. L’attaquant n’a donc rien inventé : il a simplement appliqué une vieille recette éprouvée du marketing en ligne.
Le tri peut aussi reposer sur d’autres critères que le User-agent, plus difficiles encore à mettre en évidence :
- la plage d’adresses IP du visiteur: les robots des moteurs de recherche utilisent une IP appartenant à des plages connues et vérifiables par DNS inverse
- le referrer de la requête: pour ne piéger que les internautes arrivant depuis une page de résultats.
On rencontre également des variantes qui n’impliquent aucune modification du code des pages de l’application, la logique de branchement étant placée dans un fichier de configuration du serveur web (un .htaccess contenant quelques RewriteCond sur HTTP_USER_AGENT suffit).
Via ces méthodes, même l’administrateur qui visite son propre site voit un site parfaitement sain. Seuls les moteurs de recherche voient la version empoisonnée. Et c’est précisément cette version qui finit indexée, référencée et diffusée dans les résultats de recherche du monde entier.
Une affaire de discrétion
On pourrait s’étonner de tant de discrétion. Après tout, pourquoi ne pas simplement rediriger tous les visiteurs vers des sites malveillants ?
Parce que ce serait la meilleure façon de se faire repérer : la moindre redirection suspecte alerterait aussitôt les utilisateurs comme les administrateurs du site infecté. Cela irait à l’encontre des objectifs de l’attaquant. Et pour comprendre ses objectifs, il faut remonter à ce qu’est vraiment le SEO cloaking : une technique malveillante qui vise à manipuler le référencement d’un contenu en ligne pour le faire remonter en tête des résultats de recherche. Or ce référencement repose en grande partie sur la réputation : l’ancienneté d’un domaine, sa crédibilité, le nombre et la qualité des liens qui pointent vers lui.
En servant aux robots d’indexation du contenu rempli de mots-clés et de liens visant ses propres domaines, il fait remonter ses propres sites dans les résultats liés à ces mots-clés. Ensuite, et surtout, il transfère une partie de la crédibilité du domaine compromis vers ses liens malveillants : un lien posté sur le site d’un hôtel, d’un restaurant ou d’une université de confiance pèse infiniment plus, aux yeux des algorithmes de classement, qu’un lien posté sur un site créé la veille. Plus l’empoisonnement dure, plus le référencement est efficace : d’où l’intérêt de rester furtif aussi longtemps que possible.
C’est un parasitisme numérique presque élégant dans sa discrétion : l’attaquant ne casse rien, il emprunte simplement la confiance que d’autres ont mis des années à construire.
Une infection très répandue
Dans notre cas d’exemple, en analysant le code html injecté dans la page PHP, deux termes revenaient souvent : « slot gacor ». Expression qui, au premier abord, ne vous dit probablement rien.
Pour comprendre ces termes, il faut d’abord savoir que les jeux d’argent en ligne ont connu une croissance fulgurante depuis une dizaine d’années, portée par des millions de joueurs à travers le monde en quête de sensations et de gains potentiels. Dans le jargon de cette industrie, une expression est très utilisée : « slot gacor ». Popularisée au sein de la communauté des jeux d’argent en ligne d’Asie du Sud-Est, et tout particulièrement en Indonésie, elle est devenue un véritable mot-clé de ralliement pour les amateurs de machines à sous. « Gacor » vient de l’argot local et désigne, dans le langage courant, quelque chose qui fonctionne exceptionnellement bien ou qui produit des résultats régulièrement positifs. Associé à « slot », le terme renvoie à une machine perçue comme étant sur une série gagnante, distribuant des gains fréquents et parfois conséquents.
Ces détails peuvent paraître anecdotiques, mais ils permettent de mieux cerner les motivations de l’attaquant puisque l’objectif de l’attaque sera d’apparaître dans les résultats de recherche lorsque les utilisateurs taperont ces mots-clés.
En tapant ces mots-clés sur Google, nous sommes tombés sur un grand nombre de résultats, menant vers des centaines de domaines qui, comme notre victime initiale, n’ont aucun lien apparent avec les jeux d’argent, mais hébergent le même type de contenu malveillant :
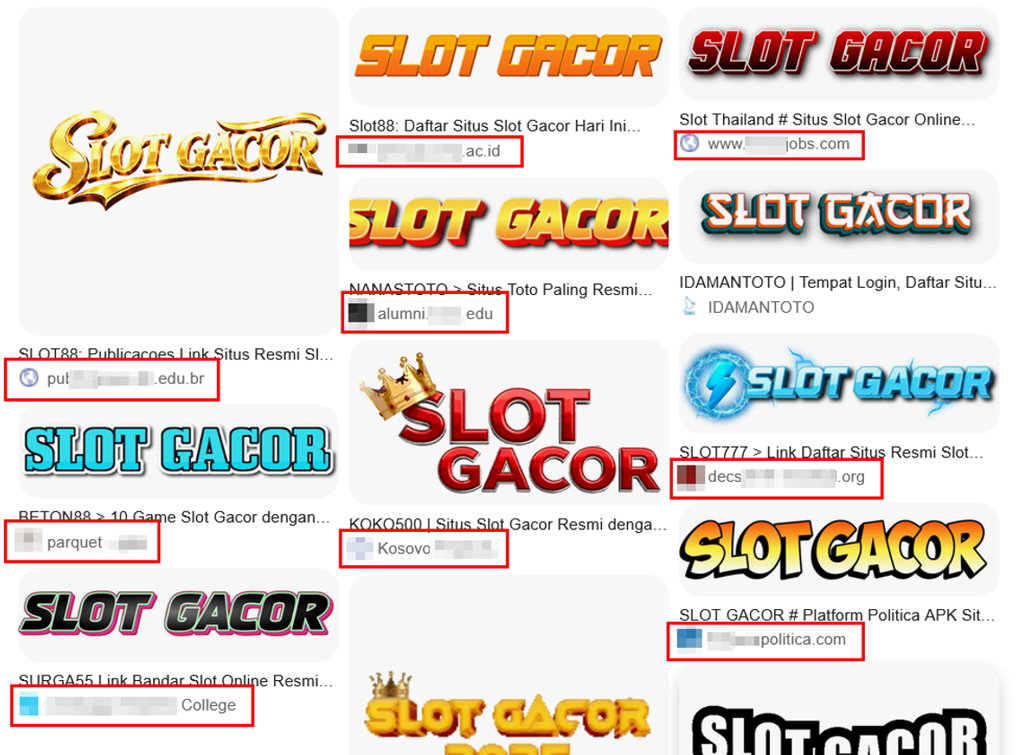
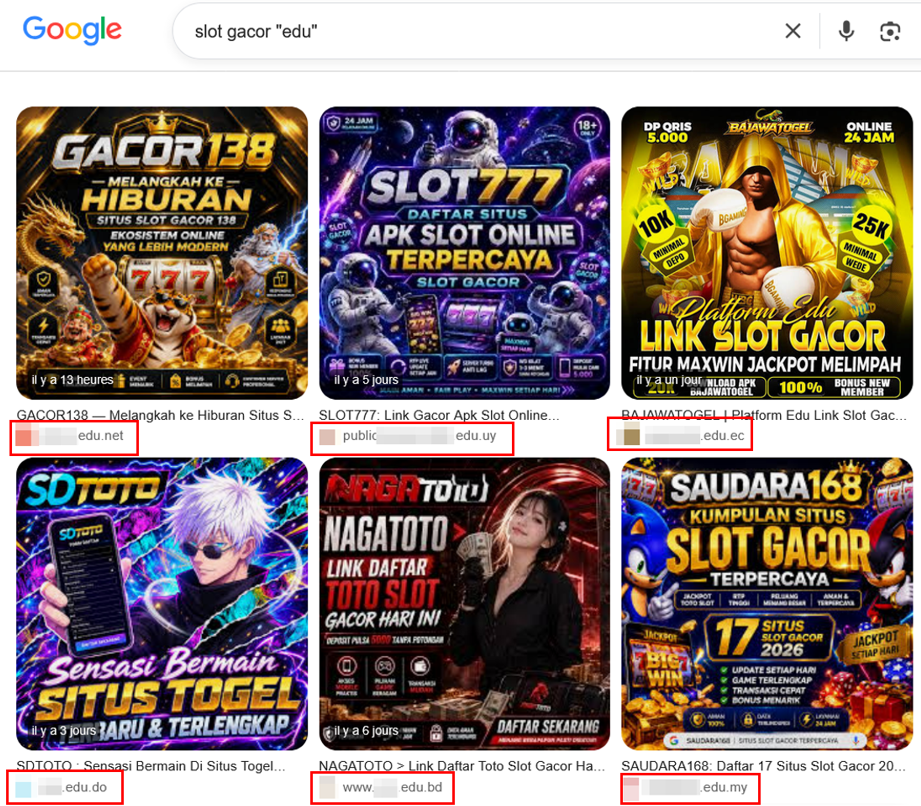
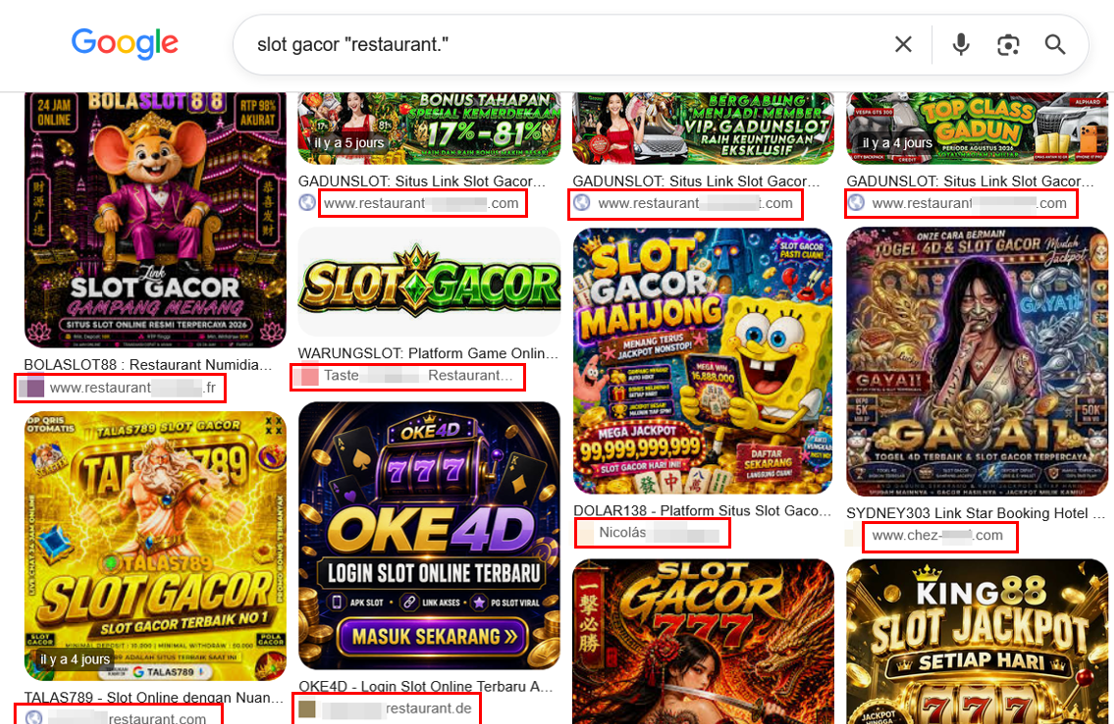
Comment on peut le constater, le profil des victimes est hétérogène: des associations, des universités, des hôtels, des boutiques, des restaurants, des blogs personnels. Des structures aux moyens de sécurité et de supervision généralement très limités, voire nuls. Elles sont plus vulnérables, moins surveillées et offrent un terrain idéal pour une compromission dont l’unique but est de durer sans se faire repérer.
Par ailleurs, d’autres termes du même univers sont venus compléter notre cartographie de ce type d’infection :
|
|
|
Autres termes identifiés durant les investigations
Cette liste laisse penser que d’autres mots-clés pourraient servir à repérer des sites compromis. Les termes que nous avons identifiés relèvent tous d’une sous-catégorie de l’univers des jeux d’argent, mais il y a fort à parier que d’autres catégories de vocabulaire permettraient de mettre au jour bien davantage de compromissions.
Le cloaking, une technique parmi d’autres
Le cas que nous avons traité illustre une seule branche d’un arbre bien plus large. Le SEO poisoning regroupe en réalité tout un ensemble de techniques, qui partagent le même objectif (détourner les mécanismes de classement des moteurs de recherche) mais diffèrent par leurs moyens et par leur finalité.
- Le cloaking, celui que nous venons de décrire : deux contenus, un pour les robots, un pour les humains.
- La redirection conditionnelle : le site reste intact, mais tout visiteur arrivant depuis une page de résultats Google est redirigé vers la plateforme de l’attaquant. Un accès direct au domaine, lui, ne déclenche rien (de quoi tromper l’administrateur qui teste son propre site).
- L’injection de liens et de texte cachés (spamdexing) : des liens sont ajoutés dans le pied de page, les commentaires ou les articles existants, puis dissimulés en CSS (display:none, texte de la couleur du fond, positionnement hors écran). Ici, la page reste unique : c’est son contenu réel qui est pollué.
- Les pages satellites (doorway pages) : plutôt que de modifier les pages existantes, l’attaquant en génère des centaines de nouvelles, souvent déposées dans un répertoire peu surveillé (/wp-content/uploads/, par exemple), parfois accompagnées d’un plan de site parasite pour accélérer leur indexation.
- Le parasite SEO : sans même compromettre de serveur, l’attaquant exploite les espaces ouverts de plateformes légitimes (forums, espaces de commentaires, sous-domaines gratuits, dépôts de documents publics) pour y héberger son contenu et bénéficier de la réputation du domaine hôte.
- Le SEO poisoning à finalité de distribution de codes malveillants : la variante la plus offensive, où le contenu positionné n’est pas une plateforme de jeu mais un faux site de téléchargement. En se plaçant sur des requêtes très spécifiques (utilitaires logiciels, modèles de documents administratifs, questions juridiques de niche), des familles comme Gootloader ou SolarMarker amènent la victime à télécharger elle-même son propre malware.
Dans notre cas du cloaking, la finalité est purement lucrative. Il ne s’agit pas d’infecter les visiteurs du site compromis, mais de capter du trafic de recherche pour le rediriger vers des plateformes de paris. Ce qui explique, en grande partie, le soin apporté à la discrétion.
Comment l’attaquant entre-t-il ?
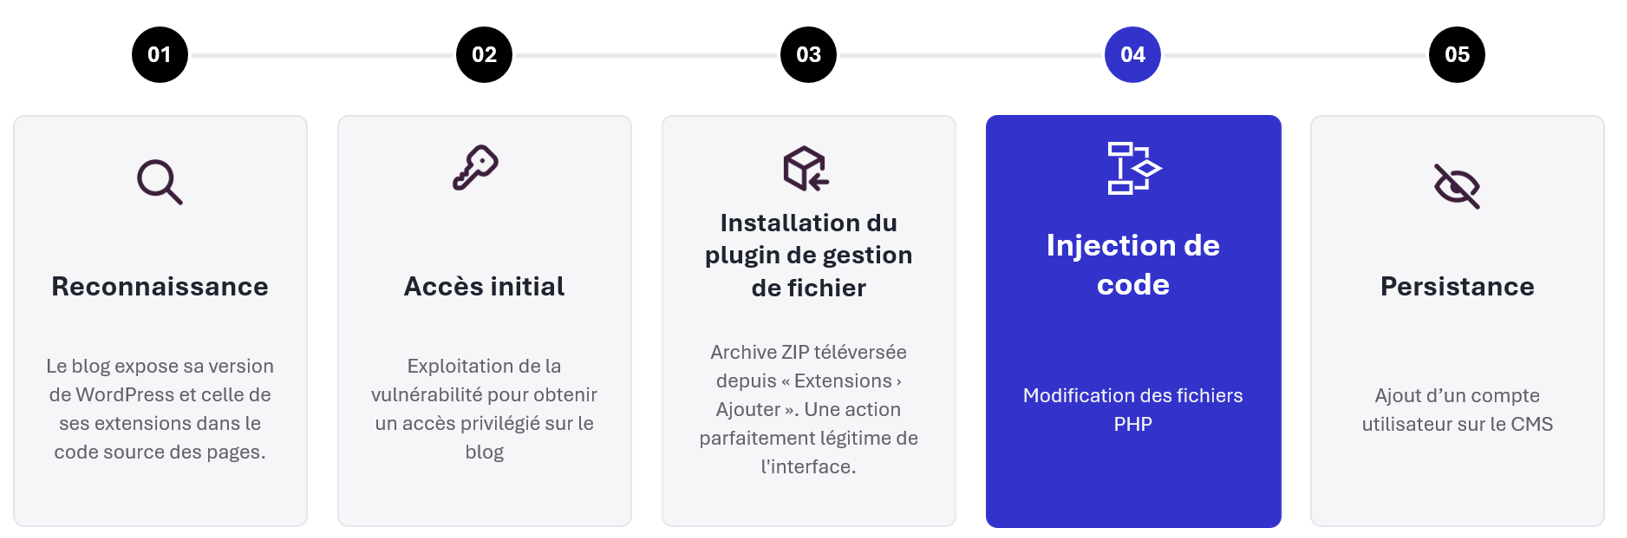
Pour insérer des lignes de code dans un fichier PHP, encore faut-il pouvoir écrire sur le serveur. Le cloaking n’est pas un vecteur d’intrusion, c’est une charge utile. En amont, il y a toujours une chaîne d’intrusion et celle-ci n’est pas nécessairement sophistiquée.
Les vecteurs les plus fréquemment observés sur ce type d’attaque:
- Un composant applicatif vulnérable : les CMS grand public (WordPress en tête, mais aussi Joomla, Drupal, PrestaShop, Moodle) reposent sur un écosystème d’extensions et de thèmes dont la qualité de développement et le suivi de sécurité ne sont pas garantis. Une vulnérabilité publiée, un correctif non appliqué et l’exploitation peut devenir triviale. Cette porte d’entrée est d’autant plus à considérer que ces CMS reposent majoritairement sur PHP, touché récemment par des vulnérabilités critiques.
- Un dépôt de fichiers insuffisamment contrôlé : Formulaire de contact avec pièce jointe, galerie photo, espace de dépôt de CV : dès lors que le contrôle porte sur l’extension déclarée plutôt que sur le type réel du fichier et que le répertoire de destination autorise l’exécution du code, le dépôt d’un webshell offre à l’attaquant un accès persistant en écriture sur l’ensemble de l’arborescence.
- Une exécution de code à distance (RCE) : Qu’elle découle d’une désérialisation non sécurisée, d’une inclusion de fichier local combinée à un empoisonnement de journaux ou d’une injection de commande, elle donne immédiatement le niveau d’accès nécessaire.
- Une interface d’administration exposée : Console du CMS, phpMyAdmin, panneau d’hébergement, interface de déploiement : accessible depuis Internet, sans restriction d’adresse IP ni second facteur, elle ne résiste qu’à hauteur de la robustesse du mot de passe qui la protège.
- Et bien d’autres
Quel que soit le vecteur, l’étape suivante est la même : établir une persistance qui survivra à la mise à jour du site. C’est cette persistance, plus que l’injection elle-même, qui explique pourquoi tant de sites « nettoyés » se retrouvent réinfectés quelques jours plus tard.
Détection et remédiation
Ce qui rend cette compromission particulièrement intéressante, c’est que dans certaines conditions elle peut être réalisée sans générer la moindre alerte au niveau des outils de sécurité. Pas de trafic anormal, pas de binaire malveillant exécuté, pas de signature connue : quelques lignes de code en plus dans un fichier de code source.
Il n’existe pas une méthode universelle pour identifier si une page est victime de SEO cloaking. Cependant une méthode simple consiste à interroger le site en se présentant successivement avec les User-Agent des différents robots de recherche, puis de comparer le résultat obtenu à celui d’un navigateur classique. Toute divergence de contenu peut être un signal potentiel de compromission. Si les deux versions sont identiques, la technique n’est probablement pas présente.
Voici un exemple de requête pour tester un site comme un navigateur classique :
curl -A "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/126.0.0.0 Safari/537.36" https://exemple.com/ -o humain.html |
La seconde rejoue exactement la même requête, en se faisant passer pour Googlebot :
curl -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" https://exemple.com/ -o googlebot.html |
Il ne reste qu’à comparer les deux réponses :
diff humain.html googlebot.html |
Sur un site sain, diff ne retourne rien ou seulement des variations mineures (jeton CSRF, horodatage, identifiant de session). Sur un site victime de cloaking, l’écart saute généralement aux yeux : deux documents entièrement différents, souvent de tailles très éloignées avec une entropie différente. La comparaison peut se répéter avec les user-agents des autres robots d’indexation (Bingbot, DuckDuckBot, YandexBot, etc.).
D’autres réflexes permettent de détecter plus rapidement la compromission d’un domaine :
- surveiller l’intégrité des fichiers applicatifs en production, afin de repérer toute modification du code source, y compris dans les fichiers de configuration du serveur web
- analyser, via une simple recherche du type site:mondomaine.tld, ce que les moteurs ont réellement indexé de votre domaine
- consulter les outils pour webmestres des moteurs de recherche, qui remontent l’apparition de pages inconnues, les pics de mots-clés incongrus et les éventuelles actions manuelles de déclassement.
Enfin, une remarque qui vaut pour la remédiation : restaurer les fichiers modifiés ne suffit pas. Sans identification du vecteur d’intrusion initial et suppression des mécanismes de persistance, la réinfection n’est qu’une question de temps.
L’ordre des opérations a d’ailleurs son importance. On commence par retirer tout ce que l’attaquant a laissé derrière lui : code injecté, extensions, comptes et fichiers ajoutés. On renouvelle ensuite l’ensemble des secrets (administration du CMS, base de données, FTP/SSH, etc.), puis on invalide toutes les sessions ouvertes. Vient enfin la mise à jour de tout composant obsolète : CMS, thèmes, extensions.
Si l’étendue de la compromission ne peut pas être établie avec certitude, la réinstallation ou la restauration depuis une sauvegarde antérieure à l’intrusion restent les options les plus sûres. À une condition d’appliquer les durcissements nécessaires avant la remise en ligne. Sinon, le site sera recompromis de la même manière.
Cette typologie d’attaque illustre une réalité que l’on oublie parfois : une attaque n’a pas toujours vocation faire du bruit ou des dégâts. Ici, la discrétion est l’objectif, plus la compromission dure sans être détectée, plus elle rapporte à l’attaquant.
Le SEO poisoning visait initialement les seuls moteurs de recherche. Mais à mesure que les agents IA parcourent le web pour le compte de leurs utilisateurs, il faut s’attendre à ce que la stratégie mute pour les viser à leur tour. Le mécanisme est identique, seule la liste des User-Agents change. Et l’enjeu, lui, n’est plus le même. Un contenu forgé pour un moteur de recherche gagne quelques places dans un classement. Un contenu forgé pour un agent IA devient une réponse, transmise à l’utilisateur avec la caution du domaine légitime consulté et sans que celui-ci n’ait jamais vu la page.
La supervision d’un site web ne doit pas s’arrêter à ce que les humains voient. Il faut aussi se demander, de temps en temps, ce qu’en voient nos amis les bots et les agents IA. Car un site peut en cacher un autre.