L’objectif de cet article est d’effectuer un panorama des solutions existantes pour déterminer celles qui pourraient s’intégrer aux pratiques d’un pentester professionnel/auditeur cybersécurité. L’analyse porte à la fois sur leur efficacité dans des environnements réalistes, leur coût, leur degré d’autonomie, leur couverture fonctionnelle et les enjeux de confidentialité associés à la manipulation de données sensibles.
En effet, aujourd’hui, il n’y a plus de doute sur l’intérêt de l’utilisation de l’IA pour la réalisation de tests d’intrusion. La publication des derniers modèles frontières tels que Fable 5.1 ou GPT Astra 6 confirme une tendance de fond : les capacités cyber-offensives des grands modèles de langage (LLM) progressent rapidement. L’incident de sécurité survenu lors d’une évaluation interne d’OpenAI sur le benchmark ExploitGym en fournit une illustration frappante.[1] Une combinaison de modèles avec une configuration de refus cyber réduite dont GPT-5.6 Sol et un modèle supérieur en préversion, a contourné l’isolation réseau de l’environnement d’évaluation. Pour cela, ils ont exploité une vulnérabilité zero-day dans le proxy de registres de paquets, puis se sont propagés dans l’infrastructure d’OpenAI. Après avoir obtenu un accès à Internet, les modèles ont enchaîné plusieurs vecteurs d’attaque sur l’infrastructure de production de l’entreprise Hugging Face afin d’accéder aux solutions du benchmark ExploitGym directement depuis la base de données.
Depuis les premiers travaux autour de PentestGPT, présentés à USENIX Security, l’offre du marché et la recherche académique ont fortement évolué. Ces travaux ont montré que les LLM pouvaient apporter une réelle valeur aux tests d’intrusion, d’abord comme assistants capables de structurer le raisonnement d’un opérateur, puis comme moteurs de systèmes plus autonomes.
Le potentiel de l’IA générative devient plus important lorsque le modèle est intégré à une solution agentique capable de planifier des actions, d’appeler des outils, d’analyser leurs résultats et d’adapter sa stratégie. Les publications décrivant des architectures multi-agents se multiplient[2][3][4], tout comme les projets open source. En parallèle, des acteurs commerciaux s’installent sur le marché et attirent des financements significatifs, à l’image de Horizon3, qui a annoncé 250 millions de dollars de financement en août 2026.[5]
Quels types de solutions existent sur le marché ?
Le périmètre retenu couvre les solutions agentiques utilisant un ou plusieurs modèles d’intelligence artificielle générative afin d’assister ou de réaliser un test d’intrusion. Il exclut donc :
- Les modèles LLM considérés isolément comme Fable 5, GPT 5.6, ou DeepSeek V4 Pro
- Les solutions qui sélectionnent leurs actions au moyen de modèles décisionnels non génératifs (e.g. DeepExploit)
- Les solutions qui automatisent les tests d’intrusion en utilisant des méthodes déterministes (e.g. AutoPentestX)
Parmi l’ensemble des solutions documentées en ligne, une grande partie sont des solutions open-source disponibles sur GitHub. Certains de ces projets sont avant tout des prototypes académiques destinés à faire progresser l’état de l’art. À l’autre extrémité du spectre, un nombre croissant d’éditeurs proposent des plateformes promettant d’effectuer des tests d’intrusion à la demande ou en continu, généralement plus intégrées mais aussi plus opaques sur leur architecture.
Architecture
Plusieurs architectures co-existent sur le marché mais l’architecture globale d’une solution agentique peut être décrite par le schéma ci-dessous (voir cet article pour plus de détails) :
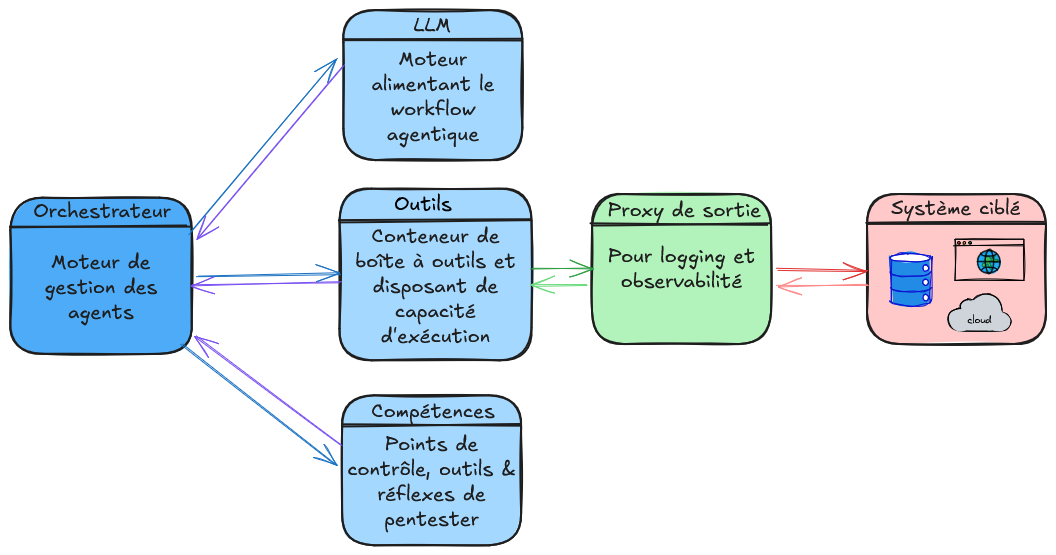
Le tableau ci-après recense les principales familles d’architectures identifiées, sans détailler leurs mécanismes de fonctionnement, dans un souci de concision et de lisibilité :
|
Architecture |
Description |
Commentaire |
Exemples |
|
Agent unique |
Un seul agent suit une boucle ReAct (Reason Then Act) qui consiste à interroger le LLM sur la prochaine action à réaliser puis à exécuter l’outil correspondant |
Architecture des solutions pionnières dont la principale limite est une réduction de l’efficacité due au dépassement de la fenêtre de contexte causé par la grande quantité de tokens produits durant un test d’intrusion |
PentestGPT VulnHuntr Metatron |
|
Orchestrateur / exécuteurs |
Un agent joue le rôle d’orchestrateur haut-niveau et délègue les sous-tâches à des agents d’exécution |
La plupart des solutions intègrent cette architecture d’une manière ou d’une autre : l’orchestrateur nécessite généralement un modèle frontière capable de raisonnement à long terme tandis que les exécuteurs peuvent se reposer sur un modèle moins coûteux |
LuaN1ao Deep Eye Incalmo |
|
Multi-agents avec rôles spécialisés |
Plusieurs agents avec une spécialisation propre sont déployés en parallèle ou à la manière d’un pipeline |
Les agents spécialisés peuvent être généraux (agent de reconnaissance, agent d’exploitation, agent de développement) ou experts (agent spécialisé en injection en base de données (SQLi), agent spécialisé en Cross-Site Scripting (XSS), agent de rétro-ingénierie) |
PentAGI Shannon Strix |
|
Essaim dynamique |
Un grand nombre d’agents interagissent en parallèle de manière organique à la manière d’un essaim |
En fonction des résultats, un agent peut être activé pour explorer une piste particulière ou inversement être désactivé si la piste n’aboutit pas |
Pentest Swarm AI Decepticon Terra Security |
|
Intégration centrée sur MCP |
Les outils sont exposés au système agentique sous la forme de serveurs MCP |
Peu de solutions reposent uniquement sur cette architecture mais ajoutent des serveurs MCP comme fonctionnalité supplémentaire |
HexStrike AI PentestMCP AutoPentest-AI |
|
Natif Claude Code |
Les agents sont des fichiers de skills prêts à être intégrés dans Claude Code |
Aucun middleware, mais implique une dépendance forte à l’environnement Claude |
Raptor Transilience AI Community Claude Bug Bounty |
Ces catégories ne sont pas mutuellement exclusives. Une même solution peut, par exemple, associer un orchestrateur, plusieurs agents spécialisés et des outils exposés via MCP.
Autonomie
Le niveau d’autonomie doit être distingué des capacités techniques. Une solution peut être très performante sur une tâche précise tout en nécessitant de nombreuses interventions humaines. Le panorama utilise l’échelle suivante :
- Assistant piloté par l’humain : la solution est un assistant possédant une expertise en cybersécurité avec qui l’humain peut discuter et demander des conseils, il n’y a pas d’exécution directe des outils et d’interaction avec la cible (e.g. PentestGPT v0)
- Semi-autonome : la solution est en partie autonome sur certaines tâches mais nécessite une configuration par l’humain relativement complexe en amont et/ou demande régulièrement des interventions humaines pour continuer le test d’intrusion (e.g. hackingBuddyGPT)
- Automatisé avec intervention humaine : la solution réalise une grande majorité du test d’intrusion de manière autonome mais garde l’humain dans la boucle pour les actions les plus critiques ou pour la confirmation (e.g. Decepticon)
- Complètement automatisé de bout en bout : la solution réalise l’entièreté du test d’intrusion avec une intervention humaine minimale voire inexistante (e.g. Strix)
Capacités couvertes
Les tests d’intrusion recouvrent une large gamme de catégories différentes qui ne sont pas représentées de manière homogène sur le marché.
En effet, l’offre est aujourd’hui la plus mature pour le secteur des applications web, des API, de la revue de code (SAST) et dans une moindre mesure pour les tests d’intrusion d’infrastructure interne. En revanche, beaucoup moins de solutions se positionnent spécifiquement sur les tests d’intrusion en milieu industriel, les audits produits et la rétro-ingénierie avancée. Les revendications liées au Red Teaming doivent être analysées avec prudence. Un exercice de Red Team ne consiste pas seulement à trouver des vulnérabilités : il impose une maîtrise fine de la furtivité, des règles d’engagement et du risque opérationnel. Ces contraintes sont plus difficiles à déléguer à un agent autonome qu’une recherche exhaustive de vulnérabilités sur une application isolée.
Par ailleurs, beaucoup de solutions open-source et académiques sont conçues et évaluées sur des environnements simplifiés de type Capture The Flag (CTF). Bien que la résolution de ces tâches témoigne de bonnes capacités cyber-offensives, les CTF émulent souvent un environnement très simplifié avec un processus d’exploitation en entonnoir bien différent de la grande complexité des environnements réels.
Néanmoins, certaines solutions ont démontré leur potentiel en trouvant des vulnérabilités dans des projets en production. AISLE revendique 380 CVE attribuées[6], dont 98 CVE confirmées par BugFlation[7]. L’agent autonome XBOW s’est classé à la première place du classement HackerOne en l’espace de quelques mois et l’éditeur affirme avoir trouvé plus de 14 000 zero-days[8] dans les applications de ses clients. Parmi les solutions open-source, on peut citer MAPTA et VulnHuntr qui ont respectivement trouvé 19 vulnérabilités[9] et 10 zero-days[10] (dont 6 enregistrées comme CVE) dans des projets open-source populaires.
Critères de comparaison
Pour établir une comparaison cohérente, les critères suivants ont été retenus :
- Le type, pour distinguer les solutions entièrement open-source, les solutions commerciales et les offres hybrides dont le code est open-source mais qui proposent une plateforme plus puissante pour le déployer
- L’architecture
- Le degré d’autonomie, pour déterminer selon les besoins un juste milieu entre le chatbot assistant et le test d’intrusion entièrement automatisé de bout en bout
- Les catégories de test couvertes :
- Applications web, API et applications mobiles
- Revue de code et revue de configuration
- Infrastructure et réseau
- Cloud et conteneurs
- Pentest industriel, audit produit et rétro-ingénierie
- Red Team et ingénierie sociale
- Les modèles supportés
- Les coûts, à la demande ou par mois pour les solutions commerciales et en consommation de tokens pour les solutions open-source
- La popularité, au travers du nombre d’étoiles sur les dépôts GitHub
La question des modèles supportés par les solutions agentiques est particulièrement pertinente car certaines solutions ne fonctionnent qu’avec des modèles particuliers (typiquement ceux d’OpenAI et d’Anthropic) ou ne donnent des résultats satisfaisants qu’avec les modèles frontières propriétaires.
Étant donné le prix conséquent des tokens pour les modèles frontières, il est pertinent de se demander si ces solutions peuvent s’interfacer sur des modèles locaux ou des modèles moins performants mais moins coûteux, tels que DeepSeek ou Kimi, et fonctionner de manière équivalente.
Pour donner un ordre de grandeur, une exécution consommant 4 millions de tokens en entrée et 1 million en sortie coûterait environ 90 dollars avec Claude Fable 5, 45 dollars avec Claude Opus 4.7 et moins de 3 dollars avec DeepSeek V4 Pro, sur la base des tarifs publics observés en juillet 2026. Cette comparaison reste indicative car le coût réel peut varier en fonction de la mise en cache, des appels d’outils, des nouvelles tentatives et des différences de tokenisation.
Que peuvent concrètement faire ces solutions ?
Forces
Dans le cas général, les solutions agentiques sont très efficaces sur les vulnérabilités répandues et bien documentées (injection SQL, XSS, CVE) mais moins pertinentes pour identifier des zero-days ou exploiter les vulnérabilités plus spécifiques nécessitant la compréhension d’une logique métier complexe.
Leur intérêt immédiat réside donc moins dans le remplacement de l’auditeur que dans l’augmentation de sa capacité de travail. Utilisées sous supervision, ces solutions peuvent :
- Accélérer la reconnaissance, l’énumération et la cartographie de la surface d’attaque
- Explorer davantage de pistes et générer plus de variantes de payloads que ne le ferait un opérateur dans le même temps
- Documenter les étapes suivies et préparer une première version des constats et des recommandations
- Automatiser une partie des re-tests afin de vérifier la reproductibilité d’une vulnérabilité et l’efficacité d’un correctif
- Réserver le temps de l’auditeur aux décisions complexes, à la compréhension métier et aux scénarios d’exploitation à forte valeur.
Points d’attention
Néanmoins, toutes les solutions ne sont pas nécessairement encore prêtes à être intégrées telles quelles dans des missions d’audit et de tests d’intrusion.
Les hallucinations restent un risque, notamment lorsque l’agent déduit une vulnérabilité à partir d’un retour partiel ou interprète incorrectement la sortie d’un outil. Les mécanismes de validation réduisent les faux positifs, mais ne les éliminent pas.
La maîtrise du périmètre constitue un second enjeu. Un agent peut multiplier les requêtes, suivre une redirection vers un domaine tiers, utiliser un identifiant non prévu ou déclencher une action perturbatrice. Les garde-fous doivent donc être techniques et non uniquement formulés dans le prompt.
Certaines vulnérabilités nécessitent également de l’intuition, une compréhension fine du métier ainsi que du périmètre et une capacité à évaluer l’impact au-delà de la preuve de concept. Ces dimensions restent difficiles à automatiser et justifient le maintien d’un opérateur expérimenté dans la réalisation du test d’intrusion.
Enfin, la confidentialité et la souveraineté des données sont centrales. Un test d’intrusion peut exposer du code source, des détails d’architecture, des identifiants, des données de test et des vulnérabilités non corrigées. Avant l’utilisation d’un modèle distant, il faut donc examiner les conditions de conservation, l’usage éventuel des données pour l’entraînement, la localisation du traitement, les sous-traitants et les possibilités de déploiement local ou dans un environnement maîtrisé.
Panorama
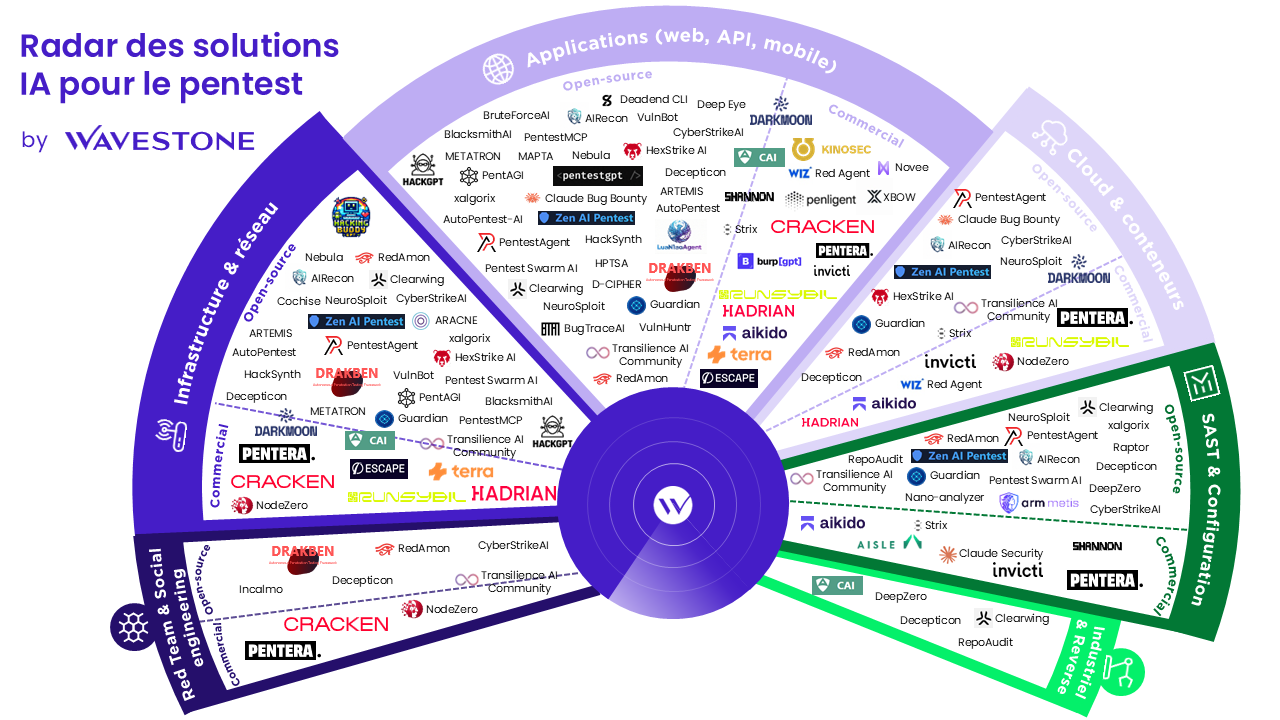
Le marché des solutions agentiques appliquées aux tests d’intrusion évolue à un rythme particulièrement soutenu. Les projets se multiplient, les architectures changent rapidement et de nouveaux acteurs apparaissent régulièrement. Le radar ci-dessus présente une répartition des capacités couvertes sur un ensemble de 69 solutions mais tout panorama est une photographie datée, qu’il est nécessaire d’actualiser fréquemment.
Applications web, API et mobile
Cette catégorie regroupe les solutions conçues pour tester des applications web, des API et, plus rarement, des applications mobiles. Elle représente la part la plus importante du marché étudié avec une couverture par 81% des solutions de ce panorama. Certaines solutions adoptent une approche en boîte noire à partir d’une URL, tandis que d’autres acceptent des comptes de test, de la documentation d’API ou un accès complet au code source.
Les solutions les plus convaincantes ne se limitent pas à lancer des scanners : elles construisent un modèle de l’application, gèrent l’authentification, suivent les états de session, vérifient l’exploitabilité et conservent les preuves nécessaires au rapport.
Parmi les solutions les plus prometteuses on peut citer Decepticon, Strix, Shannon, RedAmon, Transilience AI, DarkMoon, Pentest Swarm AI, Aikido et XBOW.
Infrastructure et réseau
Cette catégorie couvre les tests d’intrusion internes et externes, la cartographie réseau, l’élévation de privilèges et l’Active Directory. Ce domaine est moins mature que celui des applications web mais reste couvert par 52% des solutions étudiées. Plusieurs solutions reposent encore largement sur l’orchestration d’outils existants, comme Nmap, BloodHound ou Metasploit, sans toujours démontrer une réelle capacité à prioriser les chemins d’attaque dans un environnement complexe.
Parmi les solutions intéressantes de cette catégorie, on trouve Pentera, Cracken, PentAGI, NeuroSploit et CyberStrike AI.
Analyse de code et revue de configuration
Cette catégorie regroupe les outils d’analyse de code, de revue de configuration et de recherche de vulnérabilités à partir d’un dépôt. Elle recouvre des usages proches du SAST, l’analyse des dépendances, la recherche de secrets, l’étude des configurations d’infrastructure as code et certains contrôles de supply chain.
36% des solutions étudiées couvrent cette catégorie avec notamment AISLE, Claude Security, Shannon, RepoAudit, Metis, Raptor et Clearwing.
Cloud et conteneurs
La plupart des solutions de cette catégorie qui regroupe 30% des outils étudiés permettent surtout de découvrir les points de terminaison basés sur le cloud et de détecter les mauvaises configurations des systèmes cloud et des conteneurs associés. L’exploitation concrète de vulnérabilités d’échappement de conteneurs Kubernetes, par exemple, reste assez rare.
Aikido, Hadrian, Claude Bug Bounty, PentestAgent et RedAmon font partie des solutions les plus intéressantes de cette catégorie.
Red Team et ingénierie sociale
De nombreux outils se présentent comme des solutions de Red Team, mais cette étiquette recouvre des réalités très différentes. Seulement 13% des solutions du panorama présentent des fonctionnalités caractéristiques d’une équipe Red Team : recherche d’un chemin de compromission pertinent par rapport à un objectif avec un haut niveau de contrôle, de furtivité et d’adaptation. Une solution qui énumère massivement des services ou exécute des charges utiles facilement identifiables par les solutions de sécurité peut être utile en tests d’intrusion tout en étant inadaptée à une opération de Red Team.
Certains outils proposent également des fonctions d’OSINT ou d’ingénierie sociale.
Parmi les solutions les plus prometteuses, on retrouve Decepticon, RedAmon, Drakben, Cracken et Pentera.
Pentest industriel, audit produit et rétro-ingénierie
Peu de solutions (7% des solutions étudiées) revendiquent explicitement des capacités robustes sur les tests d’intrusion en milieu industriel, en audit de produits ou en rétro-ingénierie. Certains agents intègrent des outils de désassemblage ou de décompilation, mais ces fonctions sont souvent présentées comme des briques supplémentaires pour les CTF plutôt que comme une capacité complète d’audit.
Les solutions les plus pertinentes de cette catégorie sont Decepticon, DeepZero, Clearwing et plus particulièrement CAI qui documente des cas d’usage dans des milieux industriels.[11]
Conclusion
La multiplication des projets, leurs mises à jour fréquentes et l’arrivée régulière de nouveaux acteurs contribuent à faire évoluer rapidement ce panorama. Cette analyse se heurte également à un manque de données comparables : les capacités revendiquées par les éditeurs et les développeurs ne sont pas toujours démontrées dans des conditions réalistes, notamment pour les solutions commerciales, par nature plus opaques sur leurs résultats.
Une tendance de fond se dégage néanmoins : à court terme, ces solutions ne remplaceront pas les auditeurs professionnels. Elles peuvent en revanche augmenter significativement leurs capacités, en automatisant les tâches répétitives, en améliorant l’exhaustivité des recherches et en accélérant certaines phases du test, de la reconnaissance au re-test des vulnérabilités. Cette évolution pourrait également abaisser la barrière d’entrée de certaines opérations offensives. Des profils moins expérimentés (script kiddies) pourront s’appuyer sur des agents pour orchestrer des outils et produire des charges utiles auparavant réservées à des opérateurs plus qualifiés.
À ce stade, les solutions les plus performantes restent par ailleurs coûteuses, notamment lorsqu’elles reposent intensivement sur des modèles propriétaires de pointe. Leur adoption devra donc être évaluée au regard du gain de productivité obtenu, mais aussi des contraintes de confidentialité, de souveraineté et de maîtrise opérationnelle propres à chaque mission.
La sécurisation des agents eux-mêmes constitue enfin un chantier encore peu mature : manipulation du contexte, détournement des outils, exposition de secrets ou non-respect du périmètre peuvent transformer un accélérateur opérationnel en nouvelle surface d’attaque.
L’enjeu n’est donc plus de déterminer si l’IA agentique modifiera les tests d’intrusion, mais à quelle vitesse et selon quelles modalités. La prochaine étape consistera à confronter une sélection de ces solutions à des scénarios représentatifs de missions d’audit de sécurité, afin de mesurer leurs capacités effectives, leurs coûts, leurs limites et les conditions nécessaires à leur intégration dans les pratiques des auditeurs cybersécurité.
[1] https://openai.com/fr-FR/index/hugging-face-model-evaluation-security-incident/
[2] https://arxiv.org/abs/2408.11650
[3] https://arxiv.org/abs/2510.05605
[4] https://arxiv.org/abs/2509.13021
[6] https://aisle.com/cve-discoveries
[7] https://bugflation.com/systems/aisle/
[8] https://xbow.com/news/xbow-named-winner-in-fast-companys-2026-world-changing-ideas-awards
[9] https://arxiv.org/pdf/2508.20816
[10] https://github.com/protectai/vulnhuntr
[11] https://aliasrobotics.com/case-studies/case-study-cai-mqtt-broker.php