Exploiter davantage les données sans accroître les risques associés : c’est l’un des grands défis auxquels les organisations sont aujourd’hui confrontées. Pendant longtemps, cette question a été perçue comme un arbitrage difficile entre deux objectifs à concilier : valoriser les données pour innover, améliorer les services ou entraîner des modèles, tout en garantissant un niveau suffisant de protection et de maîtrise des risques. Dans certains cas, cette tension conduit les organisations à limiter leurs usages data par crainte de non-conformité ou d’exposition excessive. Dans d’autres, elle peut au contraire les pousser à accélérer leurs projets au détriment de garanties de protection robustes.
Cet équilibre devient d’autant plus complexe avec l’essor de l’IA générative ou encore des collaborations entre acteurs, qui multiplient les besoins de partage, de croisement et d’exploitation de données sensibles. Pourtant, les besoins sont bien réels : Comment entraîner un modèle d’IA sur des données de santé sans exposer les patients ? Comment permettre à plusieurs partenaires de collaborer sur des jeux de données sans révéler d’informations confidentielles ? Comment tirer parti de données à forte valeur sans en perdre le contrôle ?
Ces questions montrent que l’enjeu n’est plus seulement de choisir entre exploiter ou protéger les données, mais de trouver les moyens de faire les deux. C’est précisément dans cette perspective que les Privacy Enhancing Technologies (PETs) prennent tout leur intérêt : elles offrent un ensemble de techniques permettant de repenser l’usage des données, en conciliant création de valeur, protection de la vie privée et maîtrise des risques.
Les PETs : Une famille de technologies plus large qu’on ne le pense
Les Privacy Enhancing Technologies désignent un ensemble de technologies, méthodes et architectures visant à permettre l’exploitation de données tout en réduisant les risques associés à leur exposition, leur ré-identification ou leur usage non maîtrisé. Autrement dit, elles cherchent à rendre possible certains traitements, analyses ou collaborations, tout en renforçant la protection des informations sensibles.
Cette définition est importante, car le terme PETs est parfois utilisé de manière assez large. En pratique, il recouvre des approches très différentes, qui n’apportent pas les mêmes garanties, ne répondent pas aux mêmes cas d’usage et ne présentent pas le même niveau de complexité.
Pour comprendre les PETs simplement, on peut les regrouper en trois grandes familles.
- La première famille regroupe les technologies qui consistent à modifier les données elles-mêmes (Altering Data). On y retrouve par exemple le data masking, la , l’anonymisation, la génération de données synthétiques ou encore la differential privacy. Leur objectif est de réduire le caractère directement identifiable ou sensible des données avant leur utilisation. Ces techniques sont souvent plus simples à appréhender et peuvent faciliter certains usages de partage, d’analyse ou de test. En revanche, elles impliquent généralement un compromis : plus la protection est forte, plus la donnée risque de perdre en précision ou en utilité métier.
- La deuxième famille vise plutôt à protéger les données pendant leur traitement (Shielding Data), sans nécessairement les altérer. C’est le cas du chiffrement, du chiffrement homomorphe ou encore des environnements d’exécution de confiance (Trusted Execution Environments). L’intérêt de ces approches est qu’elles permettent de préserver l’intégrité de la donnée, tout en limitant son exposition à des tiers ou à des environnements non maîtrisés. Elles peuvent donc être particulièrement pertinentes lorsque la donnée doit rester exploitable dans sa forme initiale. Leur limite tient toutefois à leur complexité technique : elles peuvent être coûteuses à mettre en œuvre, générer de la latence ou nécessiter des compétences avancées pour être correctement déployées.
- Enfin, une troisième famille repose sur des architectures ou systèmes conçus pour limiter le partage direct des données (Architecture & Systems). Le federated learning, le secure multi-party computation ou encore certaines logiques de ségrégation des données entrent dans cette catégorie. Ici, l’idée n’est pas forcément de transformer ou de chiffrer la donnée, mais de repenser la manière dont les traitements sont organisés. Par exemple, plutôt que de centraliser toutes les données dans un même environnement, certaines approches permettent d’entraîner un modèle ou de produire une analyse sans déplacer les jeux de données sources. Ces solutions peuvent offrir des garanties fortes et s’inscrire dans une logique de privacy by design, mais elles supposent souvent une réflexion plus structurante sur l’architecture, la gouvernance et les processus existants.
Le radar présenté en Figure 1 positionne les différentes techniques selon leur catégorie. Bien que ces techniques ne soient pas exclusivement dédiées à cette finalité, elles sont fréquemment utilisées dans le cadre de l’entraînement de modèles d’IA. Afin de faciliter la lecture et l’exploitation du radar, chaque catégorie est subdivisée selon le moment d’application de la technique : avant, pendant ou après l’entraînement. Enfin, le code couleur des cases reflète le niveau estimé de difficulté de mise en œuvre de chaque technique
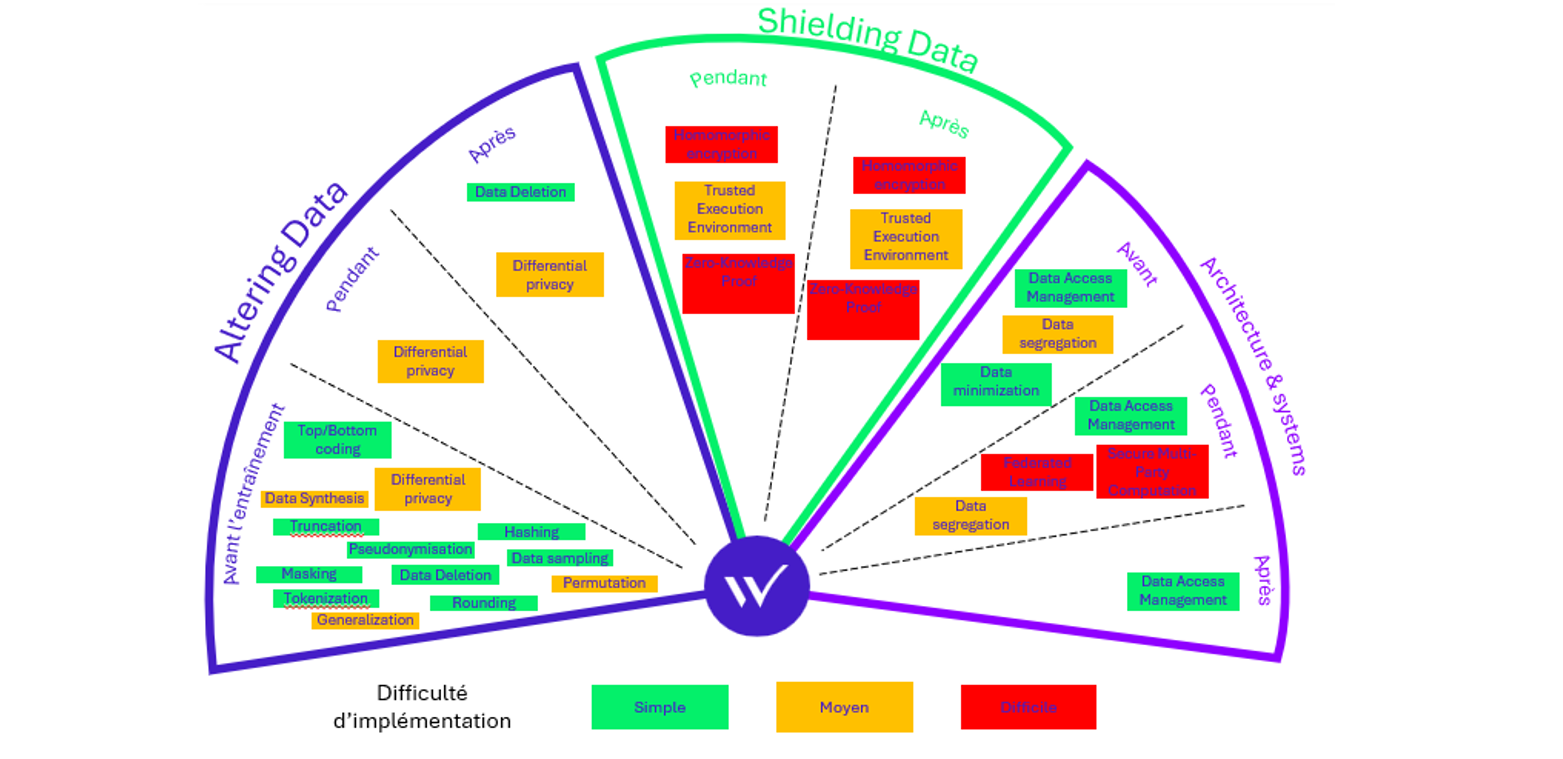
Figure 1 : radar des PETs
Cette diversité montre qu’il n’existe pas “une” PET universelle. Certaines technologies protègent en dégradant partiellement la donnée, d’autres préservent son intégrité mais au prix d’une complexité accrue, tandis que d’autres encore nécessitent de repenser l’organisation même des flux de données. Le choix d’une PET dépend donc moins de sa sophistication technique que du cas d’usage visé, du niveau de risque acceptable, des garanties attendues et des contraintes opérationnelles de l’organisation.
Des technologies matures, mais encore difficiles à industrialiser
Si les PETs ont longtemps été perçues comme des technologies de niche, elles ne relèvent plus aujourd’hui uniquement de la recherche ou de l’expérimentation. Leur développement peut être résumé autour de quatre constats.
Constat n°1 : les PETs ne sont plus un sujet exploratoire
Les PETs sont désormais identifiées par plusieurs acteurs institutionnels et de référence, comme le NIST, l’OCDE, la CNIL, l’ICO ou encore l’ENISA. Cette reconnaissance montre qu’elles entrent progressivement dans le champ des solutions concrètes mobilisables par les organisations.
Pour autant, cela ne signifie pas qu’elles apportent des garanties automatiques ou uniformes. Les autorités restent prudentes : l’efficacité d’une PET dépend fortement du cas d’usage, de son paramétrage et de sa mise en œuvre.
Constat n°2 : leur adoption reste encore concentrée chez les organisations les plus matures
Les PETs sont déjà utilisées en pratique, notamment par des organisations très avancées sur les sujets data, IA ou sécurité. Des acteurs comme Apple, Microsoft, Google, ou Uber ont par exemple communiqué sur l’usage de techniques telles que la differential privacy ou le federated learning.
Cela montre que les PETs ne sont pas uniquement théoriques. En revanche, leur adoption reste encore limitée pour de nombreuses organisations, en raison du niveau de maturité technique, des compétences et des investissements nécessaires.
Constat n°3 : toutes les PETs n’apportent pas les mêmes garanties
Toutes les PETs ne répondent pas aux mêmes risques. Certaines visent à limiter l’identification directe d’une personne, d’autres réduisent les risques de ré-identification, protègent l’accès aux données ou évitent leur partage direct entre plusieurs acteurs.
Le panorama des PETs reste très large : elles s’appliquent à des moments différents, sur des éléments différents, pour des objectifs différents. Le choix dépend donc du besoin à couvrir. Par exemple, le masking s’applique principalement aux données en entrée ou en sortie d’un traitement, tandis que la differential privacy peut s’appliquer à un jeu de données, à une requête statistique ou à un modèle. Il ne s’agit donc pas seulement de choisir une technologie “PET”, mais de comprendre précisément le risque qu’elle permet de réduire.
Constat n°4 : leur complexité d’implémentation varie fortement
Enfin, toutes les PETs ne présentent pas le même niveau de difficulté de mise en œuvre. Certaines peuvent s’intégrer relativement facilement dans des processus existants, tandis que d’autres nécessitent de revoir plus largement l’architecture, les flux de données, ou la gouvernance associée.
C’est pourquoi il est utile de les analyser selon plusieurs critères : leur famille technologique, leur moment d’utilisation dans le cycle de vie de la donnée et leur difficulté d’implémentation. Cette lecture permet de distinguer les solutions les plus accessibles des approches plus structurantes, souvent plus puissantes mais plus exigeantes à industrialiser.
Choisir une PET : Partir du cas d’usage plutôt que de la technologie
Face à la diversité des techniques disponibles, une démarche structurée de sélection devient indispensable. Le sujet n’est pas simplement de savoir si une organisation doit utiliser une PET, mais de comprendre laquelle, ou lesquelles, peuvent réellement répondre à son besoin.
Dans certaines grandes organisations, les PETs sont déjà de mieux en mieux identifiées, voire intégrées dans certains cas d’usage. En revanche, pour des organisations moins spécialisées dans l’exploitation massive de données, le passage à l’action reste plus difficile. La question n’est donc pas seulement la connaissance des PETs, mais la capacité à les qualifier, à les comparer et à les intégrer dans un environnement métier, technique et réglementaire donné.
Cette difficulté est renforcée par un effet marketing croissant. De plus en plus de solutions de privacy, de data management ou d’IA mettent en avant l’intégration de “PETs”. Mais derrière ce terme peuvent se cacher des réalités très différentes : un simple masquage de données, une pseudonymisation limitée, un module de génération de données synthétiques, ou des mécanismes cryptographiques beaucoup plus avancés. Il est donc essentiel de dépasser l’affichage commercial pour analyser concrètement les garanties apportées, les conditions d’implémentation et les limites de chaque solution.
Le choix d’une PET doit ainsi partir d’un diagnostic clair du cas d’usage. Plusieurs facteurs doivent être examinés : la finalité du traitement, la nature et la sensibilité des données, les acteurs impliqués, le niveau de confiance entre les parties, les risques à réduire, les garanties attendues, le moment auquel la protection doit intervenir, les contraintes de performance, l’architecture existante, les compétences disponibles, les coûts d’intégration, ainsi que les exigences réglementaires et de gouvernance associées.
Dans cette logique, un arbre de décision peut constituer un premier outil de décryptage. Il n’a pas vocation à fournir une réponse universelle ou à garantir qu’une technologie donnée rendra un cas d’usage conforme. Il permet plutôt de poser les bonnes questions : les données doivent-elles être partagées ? Peuvent-elles être déplacées ? Doivent-elles rester exploitables dans leur forme initiale ? Le risque principal porte-t-il sur l’identification, la ré-identification, l’accès non autorisé ou la collaboration entre plusieurs acteurs ? L’objectif est d’aider les organisations à orienter leur réflexion, à comparer les options disponibles et à identifier les premières pistes pertinentes.
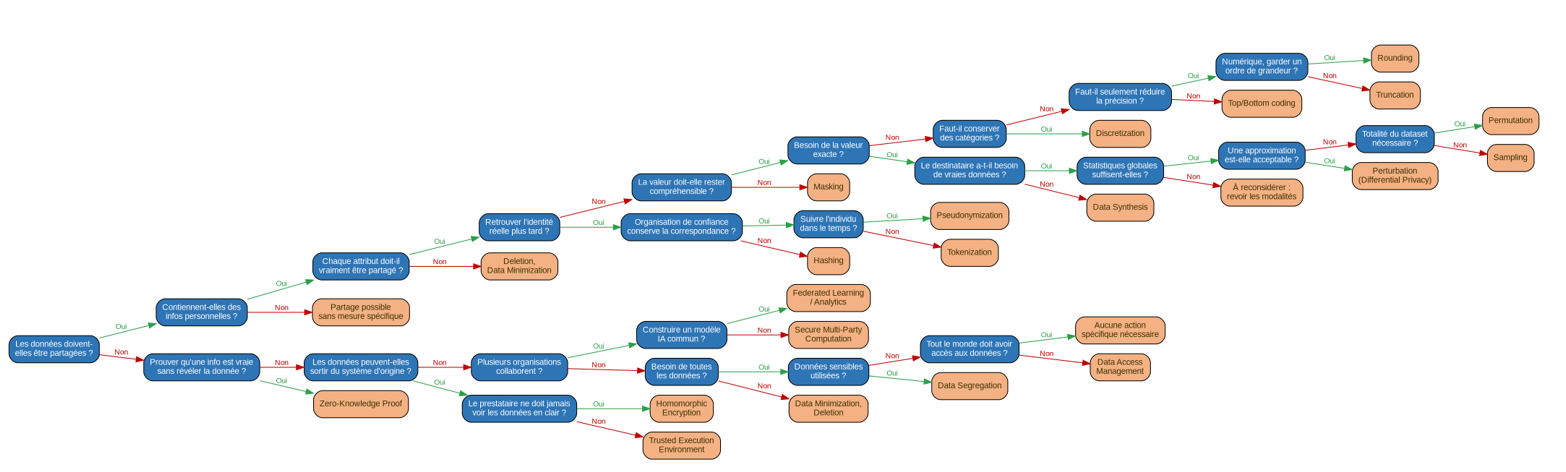
Figure 2 : Arbre de sélection d’une PET
Cet arbre doit donc être compris comme un point d’entrée dans les PETs, et non comme une méthode de sélection automatique. Le choix final dépendra toujours de l’environnement réel, du niveau de risque acceptable, des contraintes opérationnelles et de la validation juridique, sécurité et métier. Autrement dit, les PETs ne se choisissent pas “sur catalogue” : elles doivent être sélectionnées, testées et combinées au regard d’un usage précis.
Nos recommandations pour passer à l’action
Au-delà du choix technologique, la mise en œuvre des PETs doit être pensée comme une démarche progressive, contextualisée et intégrée aux usages métiers. Chez Wavestone, nous retenons trois principes directeurs.
Partir du cas d’usage, pas de la technologie
La bonne question n’est pas : “quelle est la PET la plus performante ?”, mais plutôt : “quel risque dois-je réduire, et quel usage des données dois-je rendre possible ?”
Une technologie avancée n’est pas nécessairement la plus pertinente. Le chiffrement homomorphe, la differential privacy ou les données synthétiques peuvent être très puissants dans certains contextes, mais surdimensionnés, coûteux ou inadaptés dans d’autres. L’enjeu est donc de partir du besoin réel : type de données, finalité, niveau de sensibilité, acteurs impliqués, contraintes techniques, niveau de garantie attendu et capacité d’intégration.
Cette approche permet d’éviter une lecture purement technologique des PETs, pour les considérer comme des moyens au service d’un objectif précis : permettre un usage data tout en réduisant un risque identifié.
Combiner les approches plutôt que chercher la solution miracle
Une PET ne doit pas être envisagée comme une réponse unique et suffisante. Dans la pratique, les approches les plus robustes reposent souvent sur la combinaison de plusieurs mécanismes complémentaires.
Une organisation peut par exemple associer des données synthétiques à de la differential privacy, combiner apprentissage fédéré et chiffrement, ou encore articuler pseudonymisation, contrôle d’accès et gouvernance des usages. Chaque brique contribue alors à réduire une partie du risque, sans prétendre couvrir seule l’ensemble des enjeux.
Cette logique de combinaison est essentielle à tous les niveaux : les PETs ne remplacent ni l’analyse de risque, ni les contrôles de sécurité, ni les exigences de gouvernance. Elles viennent renforcer un dispositif plus global de protection et de maîtrise des données.
Passer progressivement de l’expérimentation à l’industrialisation
Pour une organisation qui débute sur les PETs, l’objectif ne doit pas être de déployer immédiatement une architecture complexe à grande échelle. Il est souvent plus pertinent de commencer par un cas d’usage limité, avec un périmètre maîtrisé, un bénéfice clair et des critères d’évaluation définis.
Cette première étape permet de démontrer la valeur de la technologie, d’en mesurer les impacts opérationnels et d’identifier les conditions de passage à l’échelle.
Il est important de ne pas sous-estimer cette notion d’opérationnel. Sans gouvernance, compétences, processus, tests et critères d’évaluation, même une technologie pertinente risque de rester au stade de démonstrateur. Les tests sont particulièrement importants : la plupart des PETs ne fournissent pas, à elles seules, un indicateur simple et universel du niveau de protection obtenu. Leur efficacité doit donc être évaluée dans le contexte réel d’usage, avec des hypothèses, des limites et des contrôles clairement documentés.
L’industrialisation suppose ensuite d’aller au-delà : intégrer la PET dans les processus existants, clarifier les rôles et responsabilités, définir les contrôles associés, former les équipes et assurer un suivi dans le temps.
À terme, les PETs les plus efficaces sont souvent celles qui deviennent transparentes pour les métiers : elles ne constituent pas une surcouche isolée, mais s’intègrent directement dans les flux data, les processus d’analyse ou les mécanismes de partage existants.